Почему сайт не индексируется в Яндексе и Google: 10 частых причин и как их исправить
- 📌 Введение: что такое индексация, почему без неё сайт не виден в поиске и кому важно разобраться в причинах
- ↳ Что такое индексация простыми словами
- ↳ Почему это критично именно для бизнеса
- ↳ Кому важно разобраться в причинах
- 📌 Как поисковые роботы находят и добавляют страницы в индекс: базовый принцип
- ↳ Этап 1. Обнаружение: как робот узнаёт о странице
- ↳ Этап 2. Сканирование: что именно забирает робот
- ↳ Этап 3. Индексирование: превращение страницы в результат поиска
- 📌 Проверка сайта в панелях вебмастера: с чего начать диагностику
- ↳ Начните с раздела «Индексирование» — это ваш главный экран
- ↳ Проверьте sitemap и точечно — конкретные URL
- ↳ Сверьте жалобы с реальностью и зафиксируйте исходную точку
- 📌 Технические преграды: закрытые страницы, ошибки robots.txt и неверные директивы
- ↳ Случайно закрытые страницы: как сайт теряет половину каталога за один клик
- ↳ robots.txt: файл из пяти строк, который умеет ломать целые разделы
- ↳ Директивы, которые работают не так, как кажется
- 📌 Проблемы с контентом и структурой: дубли, тонкие страницы и запутанная навигация
- ↳ Дубли страниц: когда сайт конкурирует сам с собой
- ↳ Тонкие страницы: контент, которого недостаточно для индексации
- ↳ Запутанная навигация: страницы-сироты и глубина клика
- 📌 Внешние и серверные факторы: скорость загрузки, доступность и санкции
- ↳ Скорость загрузки и краулинговый бюджет: почему «медленно» равно «редко»
- ↳ Доступность сервера и стабильность отдачи кода
- ↳ Санкции и внешние сигналы: когда поисковик намеренно тормозит обход
- 📌 Практические шаги по исправлению и ускорению индексации
- ↳ Шаг 1. Расчистите дорогу и попросите переобход
- ↳ Шаг 2. Уберите дубли и склейте вес страниц
- ↳ Шаг 3. Ускорьте обход через внутренние ссылки и свежесть контента
- ↳ Шаг 4. Зафиксируйте результат и наблюдайте
- 📌 Заключение: главные выводы и чек-лист действий
- ↳ Что важно запомнить
- ↳ Чек-лист действий
Введение: что такое индексация, почему без неё сайт не виден в поиске и кому важно разобраться в причинах
Представьте, что вы открыли уютную пекарню в центре города. Свежий хлеб, аромат корицы, довольные первые клиенты. Но вот незадача: на картах и в справочниках вашего адреса нет. Люди идут мимо, не подозревая, что за неприметной дверью — та самая булочная, о которой все говорят. Примерно так же ощущает себя сайт, который по каким-то причинам не попал в индекс поисковой системы.
Что такое индексация простыми словами
Индексация — это процесс, при котором робот поисковой системы (у Яндекса и Google это отдельные программные агенты) обнаруживает страницы вашего сайта, анализирует их содержимое и заносит в свою базу данных. Эта база и есть индекс: огромный каталог, по которому поисковик мгновенно подбирает ответы на запросы пользователей.
Пока страница не в индексе, её не существует для поиска. Вы можете вложить в дизайн миллионы, написать лучшие тексты в нише — но по запросу «купить ремонт квартиры в Казани» или «онлайн-курс по бухгалтерии» пользователь вас не увидит. Ни в первой десятке, ни на двадцатой странице. Совсем.
Индексация — это не про позиции и не про трафик. Это про само право участвовать в игре. Без неё все остальные усилия по SEO и контенту просто не имеют точки приложения.
Полезно разделять три вещи, которые новички часто путают. Обнаружение — робот узнал о существовании страницы по ссылке или из карты сайта. Индексация — он её просканировал и сохранил в базе. Ранжирование — страница получила место в выдаче по конкретным запросам. Проблема, о которой мы говорим, находится на первом и втором этапах: если страница не проиндексирована, ранжироваться ей просто не в чем.
Почему это критично именно для бизнеса
Для предпринимателя индексация — не абстрактная техническая метрика, а прямой канал привлечения клиентов. Вот несколько жизненных сценариев.
Интернет-магазин бытовой техники запускает новую категорию «роботы-пылесосы с влажной уборкой». Товары загружены, цены конкурентные, фото качественные. Но страница категории закрыта в robots.txt по ошибке разработчика — и весь ассортимент невидим. Каждый день без индексации — это упущенные заказы, которые уходят к конкурентам, чьи карточки в выдаче есть.
Стоматологическая клиника открывает новое направление — имплантацию. Сайт обновили, добавили страницу услуги с подробным описанием и ценами. Проходит месяц, а запросы «имплантация зубов [город]» не приносят переходов. Причина: на страницу не ведёт ни одна внутренняя ссылка, робот о ней просто не узнал.
B2B-компания по поставке промышленного оборудования публикует экспертные статьи в блог. Контент сильный, но дублируется на трёх зеркалах сайта — и поисковик не может понять, какую версию считать основной. Страницы выпадают из индекса, а вместе с ними — и репутация эксперта в нише.
Во всех трёх случаях деньги уже потрачены: на контент, на разработку, на рекламу нового направления. Но результат обнуляется на самом первом, базовом уровне.
Кому важно разобраться в причинах
Разбираться в причинах отсутствия индексации стоит нескольким категориям:
- Владельцам и руководителям бизнеса — чтобы понимать, за что именно они платят подрядчикам и почему «сайт есть, а клиентов с поиска нет».
- Маркетологам и SEO-специалистам — чтобы диагностировать проблему по чек-листу, а не гадать, и не тратить недели на гипотезы вроде «наверное, нужны ссылки», когда дело в одной неверной директиве.
- Разработчикам и вебмастерам — чтобы не допускать типовых технических ошибок при запуске и редизайне сайтов.
- Контент-менеджерам — чтобы понимать, почему даже отличный текст не работает, если страница закрыта от робота или склеена с дублем.
Ниже мы разберём, как поисковые роботы в принципе находят и добавляют страницы в индекс — это фундамент, без которого причины неисправностей кажутся магией. Затем перейдём к практической диагностике через панели вебмастера, разберём десять частых причин — от технических преград до проблем с контентом и серверных факторов — и покажем, как каждую из них исправить. В финале вас ждёт чек-лист, по которому можно быстро проверить собственный сайт на предмет «а всё ли у нас в порядке с индексацией».
Как поисковые роботы находят и добавляют страницы в индекс: базовый принцип
Чтобы разобраться, почему конкретная страница выпала из поиска, нужно понимать путь, который она проходит до появления в результатах. Этот путь одинаков и для Яндекса, и для Google, хотя детали алгоритмов у компаний разные. Логика укладывается в три последовательных этапа: обнаружение, сканирование и индексирование. Если сбой случился на любом из них — страница в выдачу не попадёт, сколько бы сил ни было вложено в её содержание.
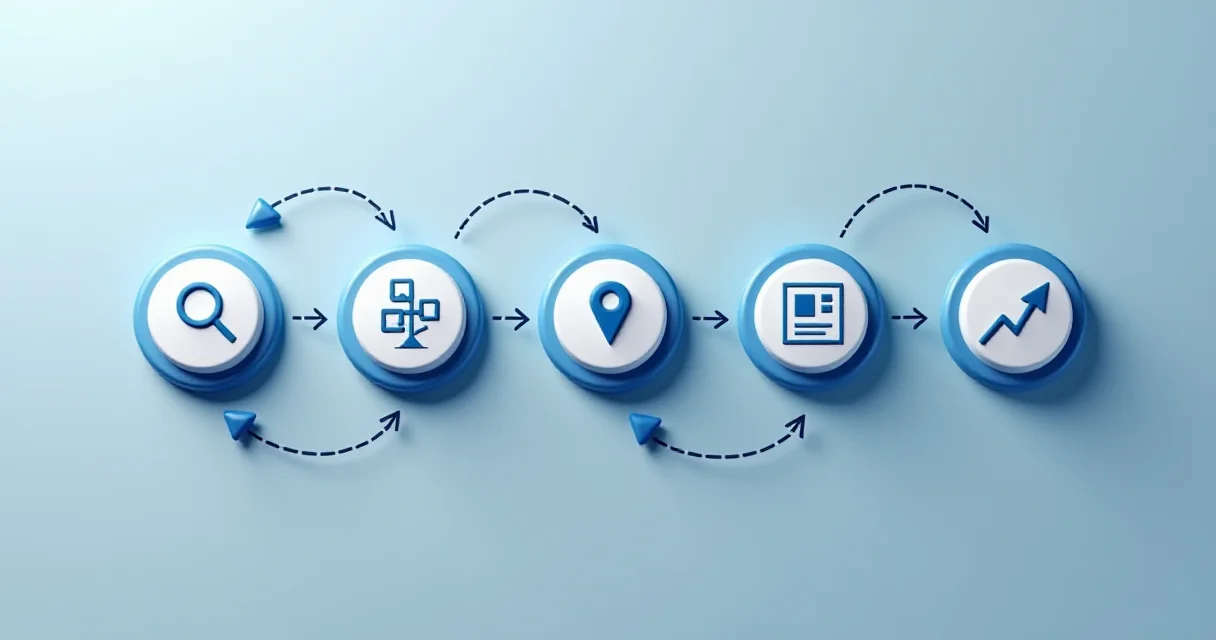
Этап 1. Обнаружение: как робот узнаёт о странице
Поисковый робот — это программа, которая перемещается по ссылкам и составляет карту доступных адресов. Новую страницу он может найти двумя путями:
- По внутренним ссылкам. Если на свежую статью или карточку товара ведёт ссылка из меню, каталога или другого материала, робот рано или поздно до неё доберётся. Именно поэтому «сиротские» страницы без входящих ссылок часто остаются невидимыми месяцами.
- Из внешних источников. Ссылки с других сайтов, упоминания в соцсетях, картах и справочниках служат дополнительными указателями. Для новых доменов это нередко единственный способ привлечь внимание краулера.
Ускорить обнаружение помогают специальные механизмы: карта сайта (sitemap.xml), протокол IndexNow, который мгновенно сообщает Яндексу и Bing об изменениях, а также инструменты ускоренного обхода в панелях вебмастера. Для интернет-магазина с тысячами карточек товаров разница между «ждать месяц» и «сообщить за минуту» — это разница между упущенными и полученными продажами.
Этап 2. Сканирование: что именно забирает робот
Обнаружив адрес, робот отправляется на страницу и «читает» её содержимое — HTML-код, тексты, изображения, метаданные. Здесь критичны три момента:
- Сервер должен отвечать. Если хостинг тормозит или отдаёт ошибку 5xx, робот уходит ни с чем и вернётся позже. Регулярные таймауты постепенно снижают доверие к сайту в целом.
- Доступность для сканирования. Директивы в robots.txt и метатег noindex могут прямо запретить обход или индексирование. Об этом подробнее — в следующих разделах, сейчас важен сам принцип: робот подчиняется правилам, которые вы ему задали.
- Качество контента. Современные алгоритмы (например, Баден-Баден в Яндексе или системы оценки полезности в Google с AI Overviews) на этапе сканирования уже анализируют смысл. Страница-пустышка с перечислением ключевых слов может быть прочитана, но не пройдёт дальше.
Робот — не волшебник, а прилежный курьер: он приходит только по известному адресу, читает только то, что ему разрешили, и запоминает только то, что показалось ему осмысленным.
Этап 3. Индексирование: превращение страницы в результат поиска
Скачанная страница попадает в хранилище поисковой системы, где проходит обработку: извлекаются сущности, темы, связи с другими документами, формируется так называемый индекс — база, по которой поисковик мгновенно находит ответы на запросы пользователей. Здесь работают алгоритмы ранжирования: Яндекс Нейро и YATI оценивают соответствие запросу, Мимикрия проверяет оригинальность текста, Google опирается на поведенческие сигналы (включая метрику INP — скорость отклика на действия пользователя).
Индексирование не мгновенно и не гарантировано. Даже просканированная страница может остаться «в очереди» или быть признана малополезной. У Google этот процесс занимает от часов до недель, у Яндекса — сопоставимо. Отдельные страницы могут попасть в индекс, но не показываться по важным запросам из-за конкуренции.
| Этап | Что происходит | Что может сломаться | Как заподозрить проблему |
|---|---|---|---|
| Обнаружение | Робот находит URL по ссылкам или sitemap | Нет входящих ссылок, закрыт sitemap | Страницы нет в отчёте об индексировании |
| Сканирование | Робот загружает и читает код | Таймауты сервера, запрет в robots.txt, noindex | Ошибки обхода, статус «заблокировано» |
| Индексирование | Страница добавляется в базу и оценивается | Дубли, тонкий контент, низкая полезность | «Обнаружено, но не проиндексировано» |
Понимание этой цепочки — ключ к диагностике. Когда вы видите, что страница «не в индексе», вопрос звучит точнее: её не нашли, не смогли прочитать или прочитали, но признали недостойной выдачи? Ответ на него задаёт направление всех дальнейших проверок.
Проверка сайта в панелях вебмастера: с чего начать диагностику
Прежде чем строить гипотезы и тем более править код, нужно увидеть реальную картину глазами поисковика. Для этого у Яндекса и Google есть собственные «смотровые площадки» — Яндекс.Вебмастер и Google Search Console. Это не просто статистика посещаемости, а прямой канал связи с роботом: здесь видно, какие страницы он знает, что с ними сделал и на что жалуется. Диагностику всегда начинайте с них — это сэкономит часы догадок.
Начните с раздела «Индексирование» — это ваш главный экран
Мысленно ответьте на вопрос из предыдущего раздела: страницу не нашли, не прочитали или не сочли достойной? Панели вебмастера отвечают на него буквально по пунктам.
В Яндекс.Вебмастере откройте «Индексирование → Страницы в поиске». Вы увидите две ключевые цифры: сколько страниц в индексе и сколько исключено. Дальше нажмите на исключённые и изучите причины — Яндекс сам их подписывает: «Малоценная или маловостребованная страница», «Запрещена в robots.txt», «Код ответа 404», «Не является основной (дубль)». Это готовый список технических ошибок, только прочитанный с другой стороны.
В Google Search Console аналогичную роль играет отчёт «Индексирование страниц». Он делит все URL на статусы: «Проиндексировано», «Просканировано, но не проиндексировано», «Обнаружено, но не просканировано», «Исключено». Если сайт молодой и вы видите десятки страниц в статусе «Обнаружено, но не просканировано» — роботу просто не хватает ресурса обхода. Если много «Просканировано, но не проиндексировано» — Google прочитал страницу и счёл её слабой. Разные статусы — разные дальнейшие действия.
Панель вебмастера — это не отчёт для галочки, а рентгеновский снимок сайта: он показывает проблему до того, как она превратилась в потерю трафика.
Проверьте sitemap и точечно — конкретные URL
Второй шаг — убедиться, что карта сайта (sitemap) вообще работает и что поисковик её видит. В Яндекс.Вебмастере раздел «Индексирование → Файлы Sitemap» покажет дату последнего чтения и число найденных в карте адресов. В Google Search Console то же самое находится в разделе «Файлы Sitemap». Если карта добавлена, но «не читалась» неделями, или в ней указано 500 адресов, а в индексе — 40, это сигнал: часть страниц карта не покрывает либо робот до них не дошёл.
Дальше — точечная проверка. Возьмите 5–10 конкретных страниц, которые «пропали», и проверьте каждую отдельно:
- Инструмент проверки URL в Google Search Console и «Переобход страниц» в Яндекс.Вебмастере покажут, когда робот последний раз был на странице и что получил в ответ;
- Отчёт о сканировании («Диагностика сайта» в Яндексе, «Опыт сканирования» в Google) раскроет, какие коды ответа возвращал сервер: 200, 301, 404 или 5xx;
- сравните статус страницы в панели с тем, что видите своими глазами в браузере — иногда разница вскрывает правду (например, страница отдаёт 200 анонимному пользователю, но 403 роботу).
Практический пример: интернет-магазин мебели заметил, что 30 карточек товаров выпали из выдачи. В Google Search Console они числились «Просканировано, но не проиндексировано», а проверка URL показала, что робот видел пустой блок с ценами — контент подгружался скриптом, который бот не выполнил. Никакого robots.txt, никаких санкций — просто робот увидел «тонкую» страницу. Без панели вебмастера этот диагноз был бы невидим.
Сверьте жалобы с реальностью и зафиксируйте исходную точку
Перед тем как идти в технические дебри, соберите базовую линию: сколько страниц в индексе сейчас, сколько было месяц назад, какие типы ошибок повторяются чаще всего. В Яндекс.Вебмастере обратите внимание на блок «Диагностика сайта» — он сводит критичные проблемы в один список: недоступность сервера, ошибки в robots.txt, проблемы с sitemap, дубли. В Google Search Console ту же роль играет раздел «Опыт» и «Ручные меры» (если там чисто — уже половина хороших новостей).
Запишите отправную точку в заметку: «в индексе — N страниц, исключено — M, главная причина — такая-то, дата проверки — такая-то». Через неделю после исправлений вы сравните цифры и увидите, двигается ли дело. Без этой фиксации любые правки превращаются в стрельбу по мишеням с завязанными глазами.
И вот здесь важный поворот: панели вебмастера редко врут, но часто показывают лишь симптом. Они говорят «страница запрещена в robots.txt» или «не просканирована» — но не объясняют, почему директива вообще появилась и что за ней стоит. Поэтому следующий шаг диагностики — разобрать конкретные технические преграды, начиная с самых коварных: закрытых страниц и ошибок в robots.txt.
Технические преграды: закрытые страницы, ошибки robots.txt и неверные директивы
Панель вебмастера сказала «запрещено в robots.txt» — и вы уже тянетесь к файлу. Это правильный рефлекс. Но прежде чем править одну строчку, стоит понять: технические преграды редко бывают одиночными. Почти всегда за одной директивой прячется целая цепочка решений, принятых в разное время разными людьми. Разберём три самые частые ловушки, в которые попадают сайты: случайно закрытые страницы, сломанный robots.txt и директивы, которые делают не то, что от них ждут.
Случайно закрытые страницы: как сайт теряет половину каталога за один клик
Классический сценарий для интернет-магазина с 8 000 товаров: разработчик ставит галочку «не индексировать» в настройках раздела, чтобы скрыть тестовую версию фильтров. Через месяц в индексе остаётся 3 000 страниц вместо 8 000, а трафик падает на 40%. Никто не связал одно с другим — потому что галочка стояла в CMS, а не в robots.txt, и в вебмастере отображалась как «исключено по метатегу noindex».
Что реально закрывает страницы от индексации:
- Метатег
<meta name="robots" content="noindex">— работает точечно и мгновенно, если робот уже видел страницу. Именно его чаще всего ставят «на время» и забывают снять. - HTTP-заголовок
X-Robots-Tag: noindex— тот же эффект, но на уровне сервера. Коварный тем, что его не видно в исходном коде страницы: вы смотрите на HTML, всё чисто, а робот получает заголовок и уходит. - Закрытие в настройках CMS — самый частый источник «фантомных» блокировок, потому что об этой настройке знает только тот, кто её включал.
Технические преграды опасны не тем, что блокируют страницу, а тем, что делают это тихо и из места, где вы не привыкли искать.
robots.txt: файл из пяти строк, который умеет ломать целые разделы
robots.txt — это не «настройка индексации», а инструкция для робота, куда не ходить. Разница принципиальная: директива Disallow не удаляет страницу из индекса, а лишь запрещает сканирование. Если страница уже в индексе, она там и останется — просто без свежего контента. Отсюда классическая ошибка: владелец закрывает раздел в robots.txt, ждёт месяц, а страницы не исчезают из выдачи.
Три поломки, которые встречаются чаще всего:
Disallow: /— случайно оставленный в шаблоне при переезде на новый движок. Сайт целиком закрыт, а вы до последнего думаете, что «просто просели».- Слишком широкие маски. Строка
Disallow: /*?закрывает всё, где есть параметр в адресе. Для каталога с фильтрами это смертельно: половина карточек товаров имеет адреса вида/catalog/iphone-15?color=blackи не сканируется вообще. - Конфликт с sitemap. В
sitemap.xmlперечислены 5 000 URL, а robots.txt запрещает сканировать 4 200 из них. Робот видит противоречие, выбирает запрет — и в отчёте вы получаете «в карте сайта указаны страницы, закрытые для сканирования».
Отдельно про директиву Clean-param — она не блокирует, а помогает роботу игнорировать UTM-метки и параметры сортировки. Если её нет, а фильтры плодят тысячи адресов одного товара, робот тратит краулинговый бюджет на дубли вместо новых страниц. К дублям мы вернёмся в следующем разделе, но корень проблемы часто лежит именно здесь, в robots.txt.
Директивы, которые работают не так, как кажется
Самая недооценённая ловушка — canonical. Казалось бы, вот же решение от дублей: указываем главную версию страницы, и все копии склеиваются. На практике три частые ошибки:
| Директива / настройка | Что думает владелец | Что происходит на самом деле |
|---|---|---|
Disallow в robots.txt |
«Страница удалится из индекса» | Страница остаётся в выдаче, но перестаёт обновляться |
noindex + Disallow вместе |
«Двойная защита надёжнее» | Робот не может прочитать noindex из-за запрета — и страница остаётся в индексе |
canonical на закрытую страницу |
«Копии склеятся с главной» | Робот игнорирует canonical, если целевая страница закрыта от индексации |
canonical на саму себя на каждой копии |
«Так правильно» | Робот видит противоречивые сигналы и индексирует все версии как самостоятельные |
Последняя строка — тихий убийца трафика. На сайте услуг из 200 страниц с одинаковыми городами-филиалами каждая страница указывает canonical на себя. Робот решает, что это 200 разных документов с почти идентичным текстом, и оставляет в индексе 15–20 «победителей», а остальные уводит в «малополезные». Проверить это можно в отчёте «Страницы» вебмастера: если десятки URL с похожим контентом имеют статус «исключено» — ищите проблему в canonical.
Ещё одна ловушка — редиректы. Цепочка из трёх-четырёх прыжков (http → https → без www → с www → слэш в конце) съедает краулинговый бюджет и иногда обрывается на 404. Один-два редиректа — норма, длинная цепочка — сигнал, что в настройках сервера и CMS живут конфликтующие правила. Кстати, проверка в панели вебмастера покажет это в отчёте «Переходы» — но только если вы туда заглянете.
Практический вывод для самодиагностики: возьмите любые 20 URL из sitemap, которые «пропали», и проверьте каждую по цепочке — ответ сервера, X-Robots-Tag, метатеги, строку в robots.txt, canonical. В девяти случаях из десяти одна из этих пяти точек окажется сломанной, и починить её можно за вечер. А вот почему страницы с корректными техническими настройками всё равно не индексируются — это уже разговор про содержание и структуру, к которому мы и переходим.
Проблемы с контентом и структурой: дубли, тонкие страницы и запутанная навигация
Технические директивы — это лишь входные двери. Но даже если робот беспрепятственно попал на страницу, у него есть все шансы уйти ни с чем. Причина — сам контент и то, как он организован внутри сайта. Поисковые системы не индексируют пустоту, повторы и страницы, до которых невозможно добраться. Разберём три самых частых «контентных» блокировщика индексации.
Дубли страниц: когда сайт конкурирует сам с собой
Самая распространённая ситуация: сайт интернет-магазина с фильтрами. Покупатель выбирает «кроссовки», потом «кроссовки мужские», потом «кроссовки мужские чёрные 42 размер» — и каждый шаг порождает новый URL с тем же товарным рядом. Формально страниц становится 3000 вместо 300. Робот заходит в этот лабиринт, видит десятки почти идентичных текстов и в лучшем случае оставляет в индексе одну версию, а остальные считает дублями.
Тот же эффект дают:
- страницы с параметрами сортировки и utm-метками;
- версии для печати и мобильные зеркала без корректного указания канонического адреса (canonical);
- карточки товаров, которые отличаются только цветом, но имеют полностью совпадающие описания.
Когда дублей много, поисковик тратит краулинговый бюджет на них, а действительно важные страницы (категории, посадочные под услуги) остаются без внимания. Робот просто не доходит до них.
Дубли — это не только про SEO-штрафы. Это про то, что ваш сайт говорит поисковику: «У меня много страниц», а по факту — одна и та же, размноженная копировальным аппаратом.
Что делать: настроить canonical на эталонную версию, закрыть в robots.txt мусорные параметры сортировки и фильтров, а для карточек с вариациями (цвет/размер) использовать одну страницу с переключателем, а не отдельные URL.
Тонкие страницы: контент, которого недостаточно для индексации
«Тонкая» страница — это не обязательно пустая. Это страница, которая не даёт ответа на запрос пользователя: три предложения текста, шаблонное описание, стоковая картинка. Классический пример — карточка услуги в B2B: «Мы оказываем бухгалтерское сопровождение. Звоните». Таких страниц на сайте может быть сто, и каждая из них не несёт уникальной ценности.
Поисковики оценивают тонкие страницы по нескольким сигналам: объём и уникальность текста, наличие структурированных данных, поведенческие факторы (дочитывают ли пользователи, возвращаются ли в выдачу). Если сигналы слабые, страница может быть проиндексирована формально — но не ранжироваться. А со временем и вовсе выпасть из индекса как «малоценная».
Показательный пример из сферы услуг: сайт клининговой компании имел 40 страниц под каждый район города с текстом, отличающимся только названием улицы. После переработки — объединения в 10 страниц с реальными кейсами, фото объектов и ценами — индексация восстановилась в течение двух недель, а трафик вырос в полтора раза.
Запутанная навигация: страницы-сироты и глубина клика
Даже идеальный текст не попадёт в индекс, если до страницы невозможно добраться за разумное число кликов. Поисковые роботы ориентируются на внутренние ссылки: чем глубже страница (например, на 5–6 уровне вложенности), тем реже её обходят. На практике это выглядит так: полезная статья о доставке спрятана в подразделе «О компании» → «Сервис» → «Документы» → «PDF», и на неё не ведёт ни одна ссылка из меню.
Другая крайность — навигация, которая выглядит логичной для человека, но нечитаема для робота: выпадающие меню на JavaScript без нормальных <a href>, «бесконечная лента» товаров без пагинации, фильтры, генерирующие ссылки только по клику. Робот не кликает — он читает HTML. Если ссылки в коде нет, страница для него не существует.
Проверить просто: откройте сайт в режиме просмотра кода (или через инструмент «Просмотр как Googlebot» в Search Console). Если важные разделы не видны в виде обычных ссылок — это и есть причина. Второй маркер — отчёт «Страницы-сироты» в панели вебмастера: там окажутся URL, на которые нет ни одной внутренней ссылки.
Лечится это перестройкой меню, добавлением хлебных крошек, блока «похожие материалы» и карты сайта в HTML-версии. Внутренняя перелинковка — не украшение, а транспортная сеть для робота.
Когда дубли размывают вес, тонкие страницы не проходят порог ценности, а навигация прячет половину разделов, даже идеально настроенный robots.txt не спасёт: индексировать будет просто нечего. Следующий шаг — проверить, не мешают ли сайту внешние и серверные факторы.
Внешние и серверные факторы: скорость загрузки, доступность и санкции
Представьте, что вы привели в порядок контент, навигацию и директивы — робот спокойно проходит по страницам, ему не мешают дубли и запреты. И всё равно позиции не растут, а часть URL так и висит в статусе «не проиндексировано». Значит, причина глубже — на уровне того, как сервер отдаёт страницы и как на сайт смотрит внешний мир.
Скорость загрузки и краулинговый бюджет: почему «медленно» равно «редко»
У поискового робота есть ограниченное время и ресурс на обход каждого сайта — это и есть краулинговый бюджет. Чем медленнее сервер отвечает, тем меньше страниц робот успевает проверить за визит. Простой пример: интернет-магазин мебели с каталогом на 8 000 товаров отдаёт страницу за 4–5 секунд из-за тяжёлых несжатых картинок и синхронных скриптов. Робот приходит, ждёт ответа, сканирует десяток-другой разделов и уходит — остальное откладывается «на следующий раз», который может наступить через недели.
Что реально бьёт по скорости и, как следствие, по индексации:
- Сервер не справляется с нагрузкой. Дешёвый тариф виртуального хостинга с базой на том же диске начинает «задумываться» уже на 30–40 одновременных посетителях. В час пик страницы отваливаются по таймауту — и робот, заставший этот момент, фиксирует ошибку.
- Нет кеширования и сжатия. Каждый запрос заново собирает страницу из базы, а HTML и статика отдаются без gzip. На практике включение кеша и сжатия сокращает отклик в 2–3 раза.
- Медленные внешние вставки. Онлайн-школа, которая поставила на все страницы чат-виджет с видео-приветствием, может «утяжелить» первую загрузку на несколько секунд — посетитель успевает уйти, а робот — поставить странице пониженный приоритет.
Ориентироваться стоит на метрики Core Web Vitals, которые обе системы используют как сигнал качества. Целевая скорость отклика сервера — до 200–500 мс, время до интерактивности — в пределах 2–3 секунд.
Доступность сервера и стабильность отдачи кода
Отдельная беда — нестабильность. Сайт то работает, то нет: обновляют плагин, перезагружают сервер, ловят сбои у хостера. Робот, наткнувшийся на серию ответов 5xx, снижает частоту визитов, а если код отдаётся дольше суток — может временно исключить страницы из выдачи. Хуже всего, когда 500-е «мигают»: сегодня сайт открылся — робот пересканировал, завтра снова упал.
Ключевая мысль: для робота «сайт иногда работает» выглядит так же подозрительно, как для клиента закрытая дверь с надписью «переучёт». Регулярные ошибки сервера — это не мелочь, а прямой сигнал нестабильности, и он влияет на то, как часто и глубоко вас будут обходить.
Что проверить: график аптайма у хостера, журнал ошибок сервера, настройки резервного копирования и время ответа в момент пиков. Если сервер регулярно отдаёт 502/503 — вопрос не в SEO, а в инфраструктуре, и никакие директивы это не компенсируют.
Санкции и внешние сигналы: когда поисковик намеренно тормозит обход
Иногда сайт технически быстрый и доступный, но индексация падает — причина в наложенных ограничениях. У Яндекса и Google есть механизмы, которые снижают доверие к сайту и притормаживают обход:
- Фильтры за некачественный контент и накрутки. Магазин сгенерировал тысячи почти одинаковых карточек товаров с подменой городов — поисковик может понизить весь домен, а не только «мусорные» URL.
- Проблемы с безопасностью. Вредоносный скрипт, редирект на сторонние сайты, «взломанные» страницы — почти гарантированный вылет из индекса до устранения.
- Массовые внешние сигналы. Резкий рост ссылок с сомнительных площадок или неестественное поведение может приводить к пессимизации — сайт остаётся в индексе, но обходится реже и ранжируется ниже.
- Явные ручные меры в панелях. В Вебмастере и Search Console есть разделы с сообщениями о санкциях — их стоит проверять в первую очередь, ещё до аналитики скорости.
Если в панели появилось предупреждение — сначала устраняете причину, потом запрашиваете переобход. Когда причина в серверной части или санкциях, никакие правки контента не дадут эффекта, пока не устранён фундамент.
Итак, база проверена: robots.txt чист, контент не дублируется, а сервер отдаёт страницы быстро и стабильно. Но даже в этом случае индексация может идти медленнее, чем хотелось бы. Как ускорить процесс и что делать с уже выявленными проблемами — разберём в следующем разделе.
Практические шаги по исправлению и ускорению индексации
Хорошая новость: большинство причин, разобранных выше, лечится за один-два рабочих дня. Плохая: если действовать хаотично, можно навредить сильнее, чем помочь. Поэтому шаги ниже выстроены в правильном порядке — от «сначала убедимся, что робот вообще может зайти» до «подтолкнём его зайти чаще».
Шаг 1. Расчистите дорогу и попросите переобход
Логика простая: пока в robots.txt стоит запрет или на странице висит мета-тег noindex, любые другие усилия бесполезны. Робот поисковой системы сначала читает правила, а уже потом решает, куда идти. Поэтому начните с трёх действий.
Снимите запреты. Если вы правили robots.txt или снимали noindex с раздела каталога, изменения вступят в силу не мгновенно — робот должен заново прочитать файл. Ускорьте это через панель вебмастера: в Яндекс.Вебмастере есть переобход robots.txt, в Google Search Console — проверка обновлённого файла. Заодно проверьте, что вы не закрыли случайно важные разделы: типичная ошибка — директива Disallow: /search или Disallow: /*? в robots.txt, которая заодно отсекает половину фильтров каталога вместе с товарами.
Отправьте URL на переобход вручную. В Яндекс.Вебмастере — раздел «Индексирование → Переобход страниц», в Google Search Console — «Проверка URL → Запросить индексирование». Не отправляйте сотни адресов сразу: поисковики ограничивают суточные квоты, а массовая отправка выглядит как спам-активность. Начните с 10–20 ключевых страниц: главной, категорий верхнего уровня, самых прибыльных карточек товаров.
Робот — не телепат. Он узнаёт об изменениях только тогда, когда вы ему об этом скажете: через обновлённый sitemap, внутренние ссылки или прямой запрос на переобход.
Проверьте sitemap. Файл карты сайта должен содержать только те адреса, которые вы реально хотите видеть в индексе, — без страниц с noindex, без редиректов, без дублей с параметрами. Если в sitemap лежит 40 000 адресов, а реальных страниц 3 000, робот тратит бюджет обхода на мусор. Урежьте файл до актуальных URL и укажите его в панели вебмастера.
Шаг 2. Уберите дубли и склейте вес страниц
Дубли — главный пожиратель краулингового бюджета. Когда один и тот же товар доступен по пяти адресам (с сортировкой, с UTM-меткой, с параметром пагинации), робот обходит все пять и не понимает, какую версию считать основной. Решение — канонические адреса.
Настройте rel="canonical". На каждой странице-дубле укажите ссылку на основную версию. Это прямой сигнал: «вот эту страницу индексируй, остальные — копии». Для интернет-магазина с фильтрами каноникал ставится на «чистый» адрес категории, для лендингов с UTM-метками — на адрес без параметров.
Закройте технические дубли в robots.txt. Страницы пагинации, сортировки, результатов поиска внутри сайта, корзины — всё это не несёт ценности для поиска. Закройте их директивой Disallow, но не забывайте: закрытые в robots.txt страницы не передают вес по внутренним ссылкам, поэтому важные разделы так закрывать нельзя.
Склейте протоколы и зеркала. Если сайт открывается и по http://, и по https://, и с www, и без — выберите одну версию, настройте 301-редиректы со всех остальных и укажите главное зеркало в панелях вебмастера.
Шаг 3. Ускорьте обход через внутренние ссылки и свежесть контента
Робот попадает на новые страницы по ссылкам. Чем ближе страница к главной по кликам, тем чаще её обходят. Практические меры:
- Поставьте ссылки на «сиротские» страницы. Если карточка товара доступна только через поиск по сайту, робот её не найдёт. Добавьте блок «Похожие товары», «Смотрите также», ссылки из категорий.
- Обновляйте контент точечно. Свежие изменения — сигнал, что страницу стоит переобойти. Не переписывайте всё подряд: обновите цены, добавьте абзац с ответом на частый вопрос, поправьте устаревшие данные. Яндекс и Google видят дату изменения и повышают частоту обхода активных разделов.
- Используйте IndexNow. Протокол позволяет мгновенно сообщить Яндексу и Bing об изменениях на сайте — страницы попадают в очередь обхода за минуты, а не за недели. Настройка занимает пару часов у разработчика, а для новостных и каталоговых сайтов это ощутимая экономия времени.
Шаг 4. Зафиксируйте результат и наблюдайте
После правок не ждите мгновенного чуда: переобход ключевых страниц занимает от нескольких дней до двух недель. Заведите простую таблицу: адрес страницы, дата правки, дата отправки на переобход, текущий статус в панели вебмастера. Раз в неделю сверяйте: сколько URL из списка перешло из «исключено» в «проиндексировано». Если через две недели статус не изменился — возвращайтесь к диагностике: возможно, причина глубже, чем казалось, и её стоит искать в серверных логах или в сигналах о качестве контента.
Заключение: главные выводы и чек-лист действий
Индексация — это не разовое мероприятие и не кнопка «включить в поиск». Это непрерывный процесс, в котором участвуют три стороны: ваш сайт, его техническое окружение и поисковые роботы. Когда одна из сторон даёт сбой, страницы выпадают из выдачи — и бизнес теряет трафик, заявки и выручку. Но, как показывает разбор десяти типичных причин, почти каждая проблема имеет понятную механику и конкретное лечение.
Что важно запомнить
Главный вывод прост: поисковик не «наказывает» сайт — он либо не может до него добраться, либо не понимает, что на странице есть ценная информация, либо не доверяет источнику. Отсюда три направления диагностики: доступ, содержание, репутация. Яндекс и Google идут по одному и тому же пути — обнаружение, сканирование, индексирование, — поэтому логика проверок универсальна, а конкретные инструменты отличаются лишь названиями панелей вебмастера.
Второй вывод касается порядка действий. Хаотичные правки вредят: сегодня закроете в robots.txt то, что вчера просили проиндексировать, а завтра получите дубли вместо склеенных страниц. Правильная последовательность — сначала расчистить дорогу (снять запреты, починить ошибки), затем убрать внутреннюю конкуренцию (дубли, тонкие страницы), потом ускорить обход и только после этого наблюдать за результатом.
Диагностика индексации — это не разовая акция «нашли и починили», а регулярный ритуал: раз в две недели заглянуть в панели вебмастера, сверить статусы и зафиксировать динамику.
Третий вывод — про терпение и метрики. Переобход ключевых URL занимает от нескольких дней до двух недель, а восстановление позиций после склейки дублей или снятия санкций может растянуться на месяц. Без таблицы наблюдения легко решить, что «ничего не работает», и снова начать менять настройки. Фиксируйте исходную точку до правок — иначе не с чем будет сравнивать.
Чек-лист действий
Ниже — сжатая последовательность, которую удобно держать под рукой. Пройдите по пунктам сверху вниз: каждый следующий шаг опирается на предыдущий.
Шаг 1. Диагностика (день 1–2)
- Откройте Яндекс.Вебмастер и Google Search Console, раздел «Индексирование».
- Выгрузите список страниц со статусом «исключено» и сгруппируйте по причинам.
- Проверьте sitemap: совпадает ли карта с реальной структурой сайта.
- Зафиксируйте исходные цифры: сколько URL в индексе, сколько исключено, сколько в очереди на обход.
Шаг 2. Расчистка технических преград (день 2–3)
- Проверьте robots.txt: нет ли случайно закрытых разделов каталога или служебных директив.
- Убедитесь, что на важных страницах нет метатега noindex.
- Проверьте коды ответа сервера: 200 для рабочих страниц, корректные 301 для переносов, отсутствие массовых 404 и 500.
- Убедитесь, что сервер стабильно отдаёт контент и не «засыпает» под нагрузкой.
Шаг 3. Работа с контентом и структурой (день 3–5)
- Найдите дубли (параметры URL, версии с www и без, http и https) и настройте склейку через канонические адреса и редиректы.
- Проверьте тонкие страницы: если контента недостаточно — объедините или закройте от индексации.
- Убедитесь, что у каждой важной страницы есть путь по внутренним ссылкам не глубже 3–4 кликов.
Шаг 4. Ускорение индексации (день 5–7)
- Отправьте ключевые URL на переобход вручную через панели вебмастера.
- Обновите sitemap и передайте его повторно.
- Добавьте свежие внутренние ссылки на страницы, которые ждут индексации.
- По возможности используйте IndexNow для быстрого оповещения поисковиков об изменениях.
Шаг 5. Наблюдение (далее — регулярно)
- Ведите таблицу: адрес, дата правки, дата отправки на переобход, текущий статус.
- Раз в неделю сверяйте, сколько URL из списка перешли в индекс.
- Если через две-три недели статус не изменился — возвращайтесь к диагностике: возможно, причина глубже (санкции, репутация, качество контента).
Индексация — это фундамент видимости в поиске. Пока он шатается, любые вложения в SEO, контент и рекламу работают вполсилы. Наведите порядок в базе — и остальные инструменты продвижения начнут приносить отдачу, на которую вы рассчитываете.